| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- TypeScript
- 재택치료
- 다들 안잊어서
- 지독한 컨셉충
- N-Queen
- pem키 분실
- 아싸의 생일
- 뽀모도로 타이머
- 대학생
- 정보처리기사 2022
- FLUTTER
- 플러터
- 개강해짐
- 자가격리
- 리눅스 마스터 2급
- 다음에 또 만나자
- 얘들아 잘 지내니
- 스프링 MVC
- 모바일 청첩장
- 수제비2022 정리
- 타입 스크립트
- CRUDS
- 정보처리기사2022
- 에러 핸들링
- 2022 정보처리기사
- 교수님 과제 이제 그만..
- 수제비 2022
- 생일축하해 나 자신
- 다행이야...ㅎ
- 교육봉사
- Today
- Total
Rei’s Tech diary
[최단 경로] 다익스트라(Dijkstra) 알고리즘 본문
📌 다익스트라(Dijkstra) 최단 경로 알고리즘
- 그래프에서 여러 개의 노드가 있을 때, 특정한 노드에서 출발하려 다른 노드로 가는 각각의 최단 경로를 구해주는 알고리즘
- '음의 간선'이 없을 때 정상적으로 동작함.
- GPS 소프트웨어의 기본 알고리즘으로 채택됨'
- 매번 '가장 비용이 적은 노드'를 선택
💡 다익스트라 알고리즘의 원리
1. 출발 노드를 설정한다.
2. 최단 거리 테이블을 초기화한다.
3. 방문하지 않은 노드 중에서 최단 거리가 가장 짧은 노드를 선택한다.
4. 해당 노드를 거쳐 다른 노드로 가는 비용을 계산하여 최단 거리 테이블을 갱신한다.
(이러한 점에서 그리디 알고리즘으로도 볼 수 있다.)
5. 위 과정에서 3번과 4번을 반복한다.
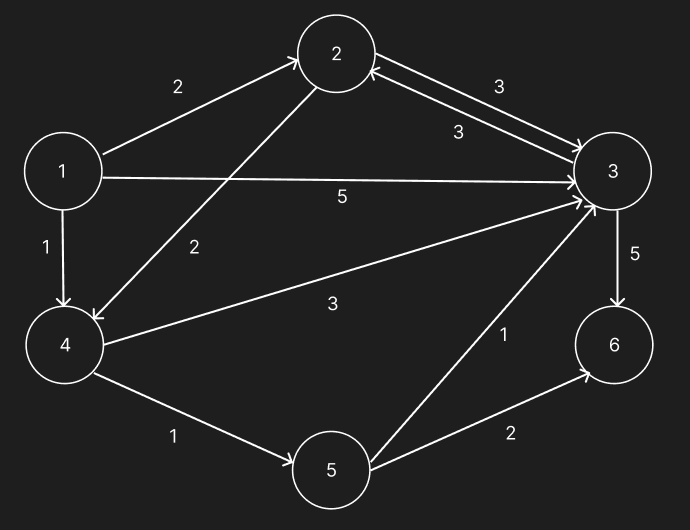
Step 0) 먼저 방문하지 않은 노드 중에서 최단 거리가 가장 짧은 노드를 선택하는데, 출발 노드에서 출발 노드로의 거리는 0으로 보기 때문에 처음에는 출발 노드가 선택된다.
| 노드 번호 | 1 | 2 | 3 | 4 | 5 | 6 |
| 거리 | 0 | 무한 | 무한 | 무한 | 무한 | 무한 |
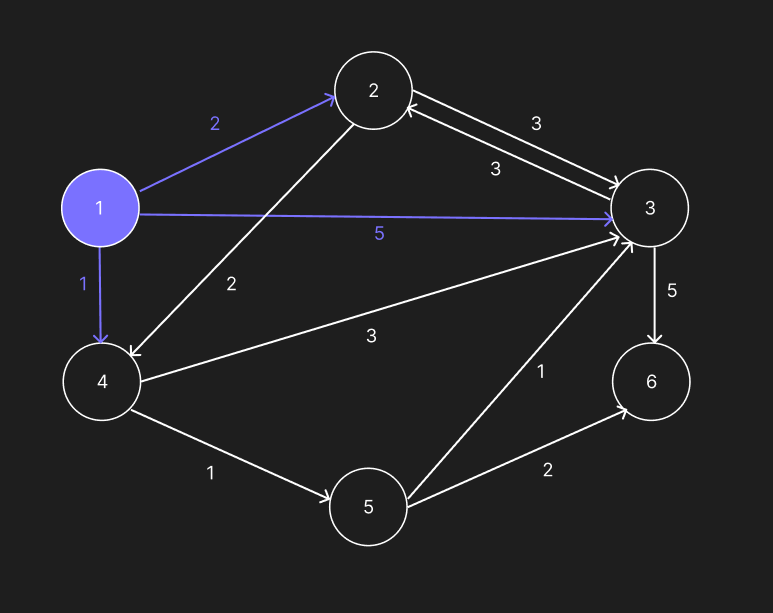
Step 1) 1번 노드를 거쳐 다른 노드로 가는 비용을 계산한다. 현재 2번 3번 4번 노드로 가는 비용이 무한으로 설정되어있기 때문에 세 노드에 대하여 더 짧은 경로를 찾았으므로 각각 새로운 값으로 갱신한다.
| 노드 번호 | 1 | 2 | 3 | 4 | 5 | 6 |
| 거리 | 0 | 2 | 5 | 1 | 무한 | 무한 |
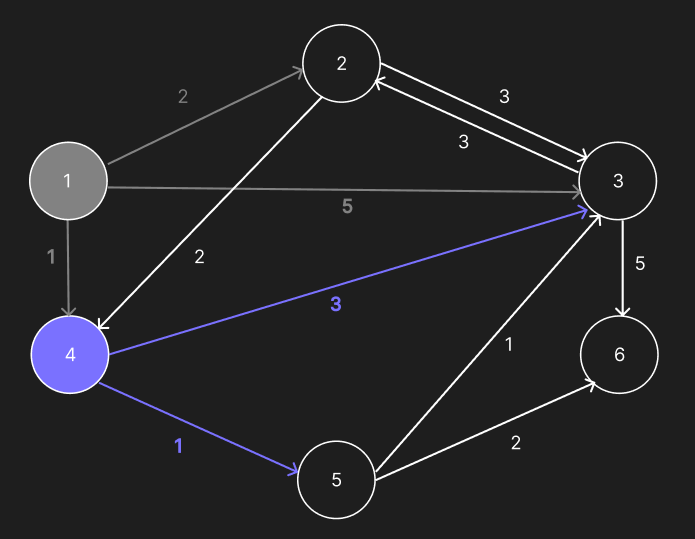
Step 2) 이후 모든 단계에서도 마찬가지로 방문하지 않은 노드 중에서 최단 거리가 가장 짧은 노드를 선택한 후, 거쳐서 갈 수 있는 노드를 확인한다. 이 때 최소비용을 계산하여 기존의 리스트에 담겨 있던 값보다 작으면 기존의 값을 갱신한다.
| 노드 번호 | 1 | 2 | 3 | 4 | 5 | 6 |
| 거리 | 0 | 2 | 4 | 1 | 2 | 무한 |
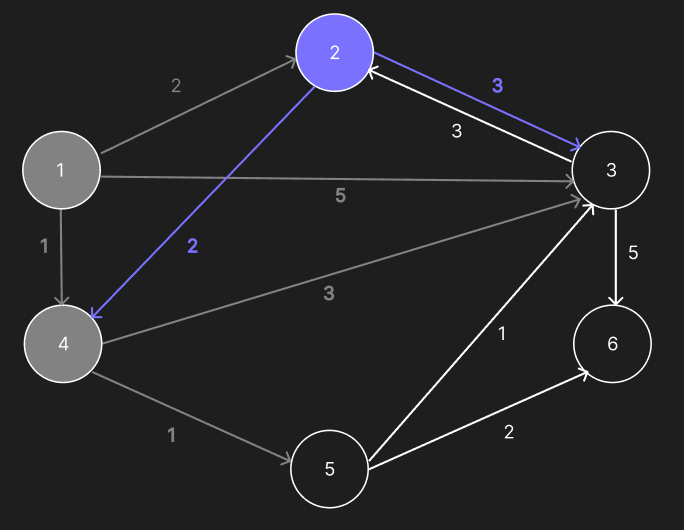
Step 3) step 3에서는 2번 노드가 선택된다. 2번과 5번의 최단 거이 값이 2로 같은데, 이럴 때는 일반적으로 번호가 작은 노드를 선택한다.
이번 단계에서는 기존의 값보다 더 짧게 갱신할 수 있는 방법이 없으므로, 리스트는 그대로 유지된다.
| 노드 번호 | 1 | 2 | 3 | 4 | 5 | 6 |
| 거리 | 0 | 2 | 4 | 1 | 2 | 무한 |
나머지 노드에 대하여 마찬가지로 과정을 계속하다보면, 최종 최단 거리 테이블은 다음과 같다.
| 노드 번호 | 1 | 2 | 3 | 4 | 5 | 6 |
| 거리 | 0 | 2 | 3 | 1 | 2 | 4 |
💡 간단한 다익스트라 알고리즘 구현 (노드가 5000개 이하일 경우)
- 시간 복잡도 : \( O(V^2) \)
- 단계마다 방문하지 않는 노드 중에서 최단 거리가 가장 짧은 노드를 선택하기 위해서 매 단계마다 1차원 리스트의 모든 원소를 확인함
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.StringTokenizer;

class Node {
    private int index;
    private int distance;

    public Node(int index, int distance) {
        this.index = index;
        this.distance = distance;
    }

    public int getIndex() {
        return this.index;
    }

    public int getDistance() {
        return this.distance;
    }
}
public class Dijkstra1 {
    //무한을 의미하는 값으로 10억 설정
    public static final int INF = (int) 1e9;

    // 노드의 개수(N), 간선의 개수(M), 시작 노드 번호(Start)
    public static int n, m, start;

    public static ArrayList<ArrayList<Node>> graph = new ArrayList<ArrayList<Node>>();

    // 방문한 적이 있는지 체크하는 목적의 배열 만들기
    public static boolean[] visited = new boolean[100001];

    // 최단 거리 테이블 만들기
    public static int[] d = new int[100001];

    // 방문하지 않은 노드 중에서, 가장 최단 거리가 짧은 노드의 번호를 반환
    public static int getSmallestNode() {
        int min_value = INF;
        int index = 0;
        for(int i = 0; i <= n; i++) {
            if(d[i] < min_value && !visited[i]) {
                min_value = d[i];
                index = i;
            }
        }
        return index;
    }

    public static void dijkstra(int start) {
        d[start] = 0;
        visited[start] = true;
        for(int j = 0; j < graph.get(start).size(); j++) {
            d[graph.get(start).get(j).getIndex()] = graph.get(start).get(j).getDistance();
        }

        //시작 노드를 제외한 전체 N - 1개의 노드에 대해 반복
        for(int i = 0; i < n - 1; i++) {
            int now = getSmallestNode();
            visited[now] = true;
            for(int j = 0; j < graph.get(now).size(); j++) {
                int cost = d[now] + graph.get(now).get(j).getDistance();
                if(cost < d[graph.get(now).get(j).getIndex()]) {
                    d[graph.get(now).get(j).getIndex()] = cost;
                }
            }
        }

    }

    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st = new StringTokenizer(br.readLine());

        n = Integer.parseInt(st.nextToken());
        m = Integer.parseInt(st.nextToken());

        st = new StringTokenizer(br.readLine());
        start = Integer.parseInt(st.nextToken());

        //그래프 초기화
        for(int i = 0; i <= n; i++) {
            graph.add(new ArrayList<Node>());
        }

        //모든 간선 정보 입력받기
        for(int i = 0; i < m; i++) {
            st = new StringTokenizer(br.readLine());
            int a = Integer.parseInt(st.nextToken());
            int b = Integer.parseInt(st.nextToken());
            int c = Integer.parseInt(st.nextToken());

            graph.get(a).add(new Node(b, c));
        }

        Arrays.fill(d, INF);

        dijkstra(start);

        for(int i = 1; i <= n; i++) {
            if(d[i] == INF) {
                System.out.println("INFINITY");
            }else {
                System.out.println(d[i]);
            }
        }


    }

}
💡 개선된 다익스트라 알고리즘 (10000개 이상)
- 시간 복잡도 : \( O(E \log V) \)
- 방문하지 않는 노드 중에서 최단 거리가 가장 짧은 노드를 선택하는 과정을 힙 자료구조를 이용하여 처리
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.PriorityQueue;
import java.util.StringTokenizer;

class Node2 implements Comparable<Node2> {
    private int index;
    private int distance;

    public Node2(int index, int distance) {
        this.index = index;
        this.distance = distance;
    }

    public int getIndex() {
        return this.index;
    }

    public int getDistance() {
        return this.distance;
    }

    @Override
    public int compareTo(Node2 o) {
        if(this.distance < o.distance) {
            return -1;
        }
        return 1;
    }
}


public class Dijkstra2 {
    public static final int INF = (int)1e9;
    public static int n, m, start;
    public static ArrayList<ArrayList<Node2>> graph = new ArrayList<ArrayList<Node2>>();
    public static int[] d = new int[100001];

    public static void dijkstra(int start) {
        PriorityQueue<Node2> pq = new PriorityQueue<>();
        pq.offer(new Node2(start, 0));

        d[start] = 0;

        while(!pq.isEmpty()) {
            Node2 node = pq.poll();
            int dist = node.getDistance();
            int now = node.getIndex();

            if(d[now] < dist) continue;

            for(int i = 0; i < graph.get(now).size(); i++) {
                int cost = d[now] + graph.get(now).get(i).getDistance();

                if(cost < d[graph.get(now).get(i).getIndex()]) {
                    d[graph.get(now).get(i).getIndex()] = cost;
                    pq.offer(new Node2(graph.get(now).get(i).getIndex(), cost));
                }
            }
        }
    }

    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st = new StringTokenizer(br.readLine());

        n = Integer.parseInt(st.nextToken());
        m = Integer.parseInt(st.nextToken());

        st = new StringTokenizer(br.readLine());
        start = Integer.parseInt(st.nextToken());

        //그래프 초기화
        for(int i = 0; i <= n; i++) {
            graph.add(new ArrayList<Node2>());
        }

        for(int i = 0; i < m; i++) {
            st = new StringTokenizer(br.readLine());
            int a = Integer.parseInt(st.nextToken());
            int b = Integer.parseInt(st.nextToken());
            int c = Integer.parseInt(st.nextToken());

            graph.get(a).add(new Node2(b, c));
        }

        Arrays.fill(d, INF);

        dijkstra(start);

        for(int i = 1; i <= n; i++) {
            if(d[i] == INF) {
                System.out.println("INFINITY");
            }else {
                System.out.println(d[i]);
            }
        }
    }
}
참고 )
이것이 취업을 위한 코딩 테스트다 with 파이썬 | 나동빈 - 교보문고
이것이 취업을 위한 코딩 테스트다 with 파이썬 | IT 취준생이라면 누구나 입사하고 싶은 카카오ㆍ삼성전자ㆍ네이버ㆍ라인! 취업의 성공 열쇠는 알고리즘 인터뷰에 있다!IT 취준생이라면 누구나
product.kyobobook.co.kr
'프로그래밍 > Algorithm' 카테고리의 다른 글
| [그래프] 크루스칼(Kruskal) 알고리즘 (최소 신장 트리) (2) | 2025.08.02 |
|---|---|
| [최단 경로] 플로이드 워셜(Floyd-Warshall) 알고리즘 (3) | 2025.08.01 |
| 📊그래프의 두 가지 표현 방식 (인접 행렬 vs 인접 리스트) (5) | 2025.07.24 |
| [Java] Comparable vs Comparator 정리 (2) | 2025.07.14 |
| [레이튼 교수와 이상한 마을] 체스판의 퀸1을 알고리즘으로 풀어보자. (0) | 2025.03.01 |


